你能看出这段文字是哪个模型写的吗?不是“这是不是 AI 写的”——那个问题已经很难赢。我问的是更窄、也更奇怪的问题:给你一段文本,你能不能指出它的模型家族和具体变体?这开始只是一次 benchmark 练习,后来变成了一堂关于数据卫生、不确定性,以及我们如何被一个数字说服的课。
问题
大多数“AI 文本检测”只关心一段文字是不是机器生成的。归因问的是更难的问题:哪台机器?这个提法有用,因为它迫使你把模型自己的风格,与管线里的其他东西分开——prompt、文体、格式习惯,以及供应商在返回文本前做的后处理。
如果分类器能学到这个分离,它就成了一件小而可测试的溯源工具。如果学不到,失败通常比准确率更有意思。你会知道自己的标签里到底装了什么。
实验设置
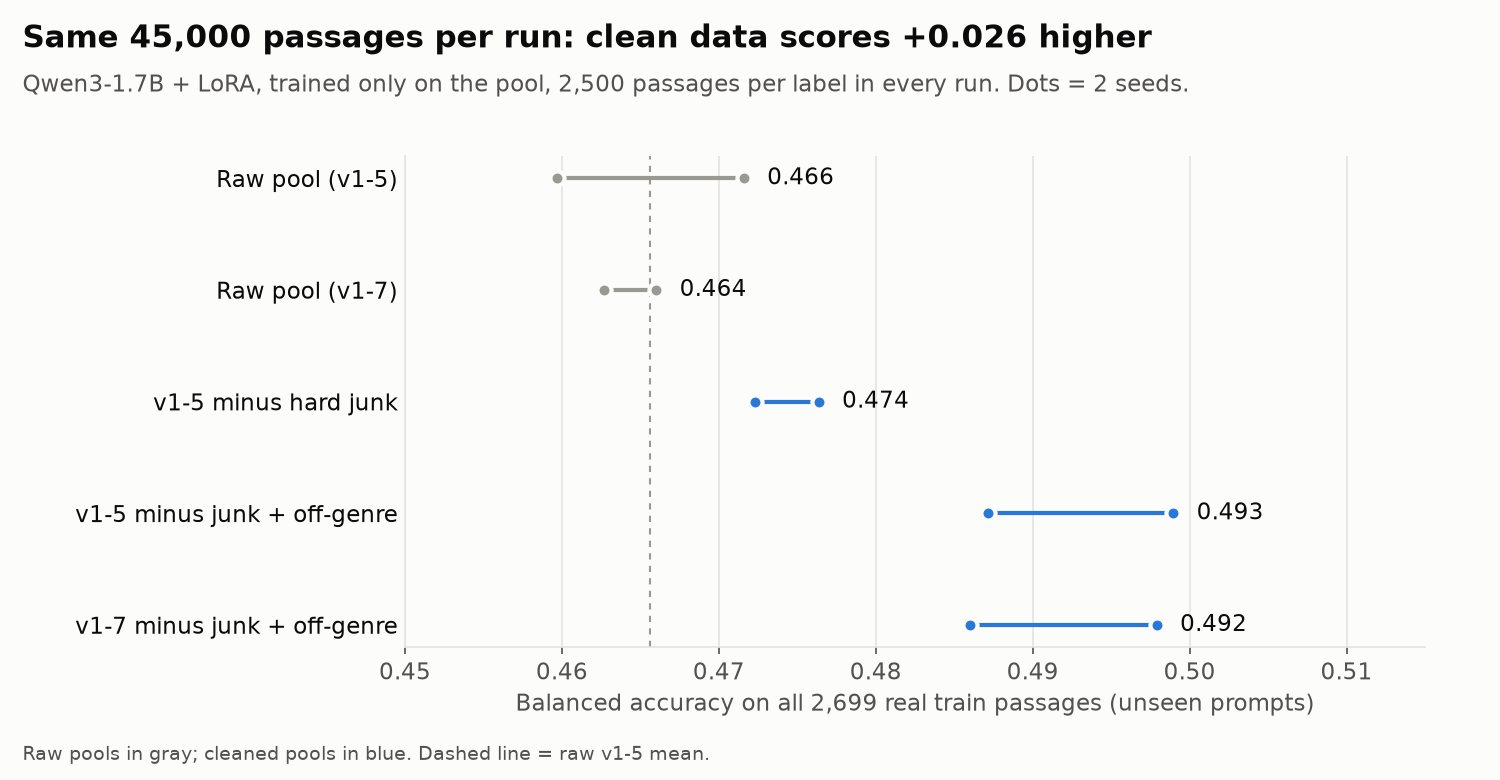
研究使用一个开放的文本池,覆盖 18 个模型变体。每轮训练用 45,000 条文本——每个标签 2,500 条——在 2,699 条真实竞赛文本上评测,这些文本对应的 prompt 从未出现在训练集里。分类器是故意做小的:Qwen3-1.7B 基座加 LoRA。每个条件跑两个随机种子。目标不是赢榜,而是弄清楚哪些干预真的改变了结果。
“小”是特性。1.7B 模型足够便宜,可以反复重跑,而且它的错误是看得懂的。大模型失败时,原因可能藏在容量里;小模型失败时,你通常能指回数据。
先清理房间
第一个干预不是架构,而是打扫:从训练池里移除明显的垃圾和跑题文本,同时保持标签平衡和评测集不变。原始数据池的平衡准确率是 0.466,清理后是 0.493。模型、数据量、随机种子都一样,提升 0.026。
这不是一个戏剧性的数字,但它有用。它说明分类器把相当一部分容量花在了“这段话来自这个数据集”和“这段话看起来像任务文本”的区别上,而不是模型声音之间的区别。清理没有增加信息,它移除了一个竞争信号。
更好的数据没有让模型变聪明,它让问题变得更容易听见。
如果你的归因模型学到的是语料,而不是模型,增加参数只会让它更自信地犯错。先修语料。
第二个种子讲了同样的故事:原始 0.464,清理后 0.492。具体数值变了,方向没变。这种一致性比 headline 的提升更重要,因为单个种子可以让任何干预看起来都像进步。
误差棒也是结果
实验用三种方式打分:全部 prompt、留出一半 prompt 不参与拟合、每个 prompt 取两个答案以更接近测试分布。区间不是装饰。好几个在点估计上看起来很有希望的想法,在画出范围后就塌了。有一个特征在第一颗种子上有提升,但第二颗没有复现,于是没有进入最终文件。
这是应用研究里最不性感、也最值得信任的部分。一个能经得起 prompt 级重采样的结果,和一个只在某个随机种子上成立的结果,是两种不同的东西。前者可以继续搭,后者只是一个带小数点的传闻。
3.7 的问题
最有教益的失败来自两个本应不同的变体:Gemini 3.7 和 3.8,来自同一个来源。一个专门区分它们的分类器 AUC 是 0.498——基本等于随机。文本里根本没有稳定信号。在混合来源的真实文本上,同一个比较能到 0.582,好一些,但仍然不是一个可以用来下溯源结论的指纹。
这里,归因不再是一个把戏。一个模型的“声音”不是它权重的稳定属性,而是训练数据、解码设置、系统 prompt,以及供应商在你看到文本前做的所有归一化的残留。如果两个变体共享同一条管线,你想检测的差异可能根本不存在于输出里。
反过来也成立。有些变体很容易分开,因为它们的格式和拒答风格很独特。这不一定是对模型更深的理解,可能只是一条捷径——供应商改一个模板,它就会消失。
改变了什么
做完之后,我对评测工作的默认做法变了:
- 按 prompt 切分,而不只是按行。 同一个 prompt 可以生成互相泄漏的文本。如果切分不尊重生成单位,分数就是虚高的。
- 报告随机种子。 一次运行是轶事,两次是方向,更多才是结果。
- 审计标签,不只审计模型。 标签是发布者的声明,有些干净,有些是营销。分类器会老老实实学会这个差别。
- 偏爱无聊的 baseline。 一个切分干净的小模型,比一个切分泄漏的大模型更像仪器。
- 保留失败的干预。 没有复现的特征也是结果的一部分。删掉它,研究就变成了高光集锦。
局限
这是一个公共数据池上的小研究,不是对所有 LLM 的结论。1.7B 分类器是探针,不是生产级检测器。标签只和来源一样可靠。归因本身也是对抗性的:供应商会改 serving stack,prompt 会改变行为,一个今天看起来很有辨识度的模型,可能在一次模板更新后就变得无法区分。
能泛化的是方法:隔离信号、测量不确定性,并把干净的负结果也当成信息。模型可以错,评测不该错。
方法 / Qwen3-1.7B + LoRA,每轮 45,000 条文本,每个标签 2,500 条,两个随机种子,2,699 条留出的真实文本。图表显示平衡准确率;区间反映 prompt 级重采样。公共数据池和导出的图表是上述数字的来源。这是一份现场报告,不是同行评审论文。