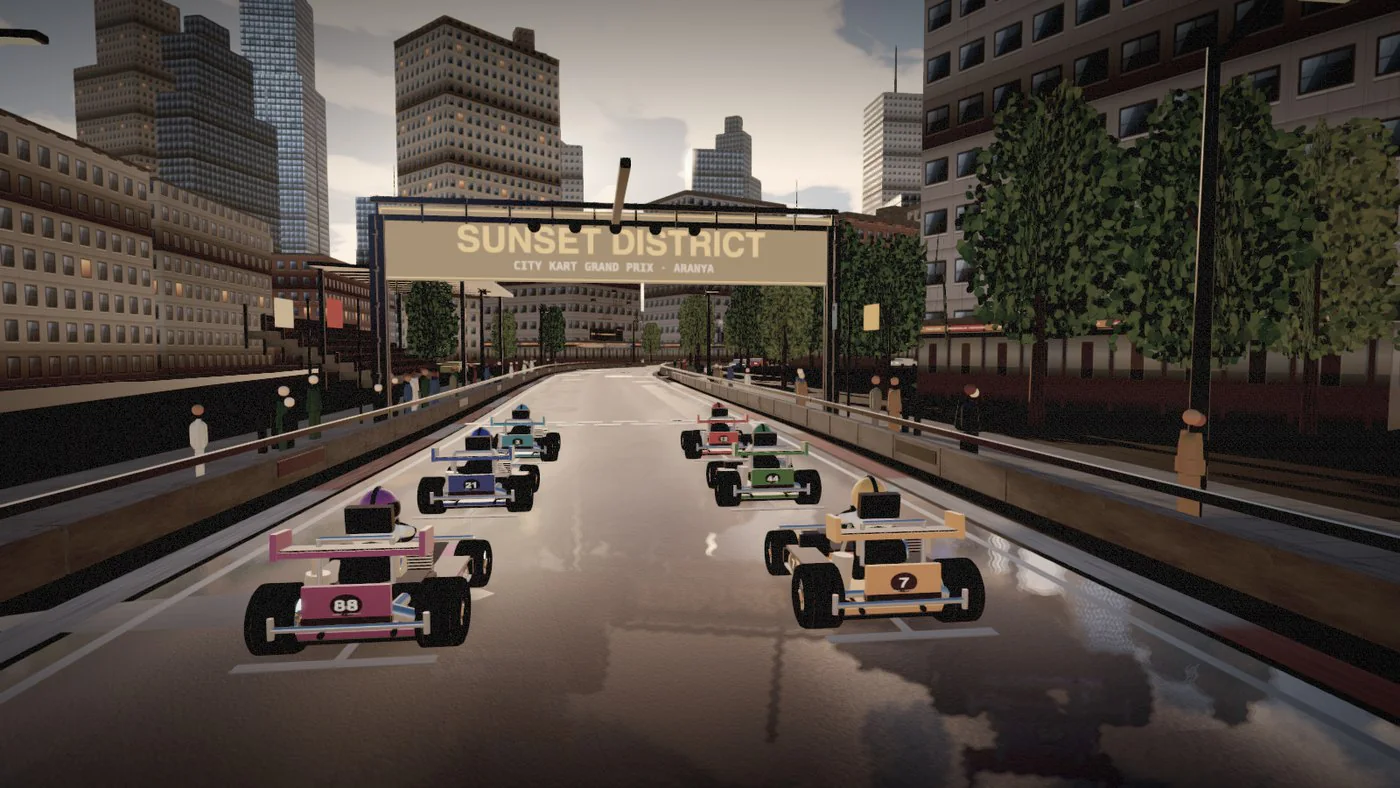
案例 013D 城市卡丁车A/B
用——当交付物是一场完整的比赛。
不用 skill 的对照版和用 skill 的版本,同一个 brief。skill 版更大、更慢,但明显更接近一个产品;对照版更小,已经很好玩。
读案例
案例 / 证据
同一个模型,同样的单文件约束,不同的 harness。这些不是受控模型评测,而是受控 harness 对照。问题始终是:harness 改变了什么,又抓到了什么?
01证据表
不写失败的案例就是营销。Ironsight 也在这里,虽然它没有公开:正是它催生了 product 门。
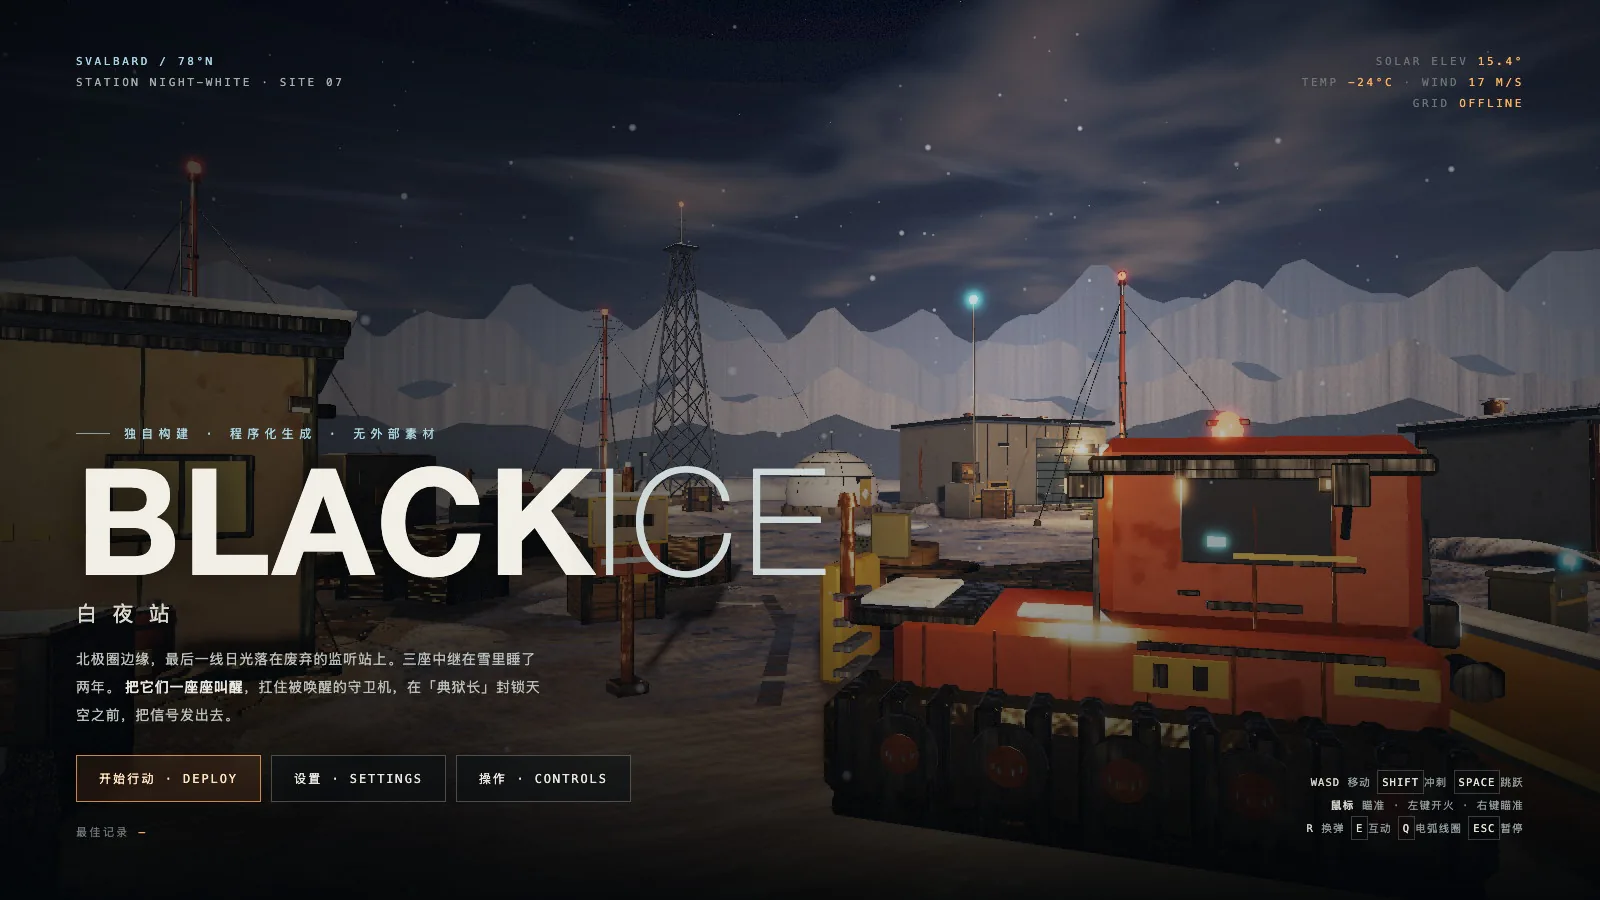
| 运行 | 品类 | Harness | 体积 | 验收门 | 结论 |
|---|---|---|---|---|---|
| Sundown Circuit | 城市卡丁车 | 无 | 890 KB | — | 核心强,外壳薄 |
| Sunset District | 城市卡丁车 | skill + 验收门 | 1.58 MB | 8/8 | 用 |
| Neon Breach | 枪战 | 无 | 304 KB | — | 内容强,风格化 |
| Ironsight | 枪战 | skill v1 | 1.50 MB | 6/6 | 不够 |
| Black Ice | 枪战 | skill v2 | 318 KB | 8/8 | 用,但有预算 |
| Saltline | 枪战 | — | 1.42 MB | — | 参考 |
验收门是该次运行声明的验收命令。不是受控模型评测
02怎么读一次运行
A/B 里模型不变,变的是 harness。它隔离的是 harness,不是模型。它不能证明 skill 比人更好,也不能证明 318 KB 优于 1.4 MB。
它证明
product 门把第二版射击游戏从“一种敌人的画面”推到“四种角色、一个 Boss、设置和存档”的游戏。验收命令变了,运行结果才变。
harness 效应它不证明
skill 把判断委托给检查,但美术方向、题材和最终否决仍然需要人眼。全绿是地板,不是天花板。
人眼否决它需要
用别的题材生成的 profile 量的是风格相似度,不是完成度。没有项目 profile 时,look 门会明确退化为色调与空置检查。
校准03 / 继续读
每份都包含 brief、数字、截图、验收输出和失败——包括验收门没抓到的那些。