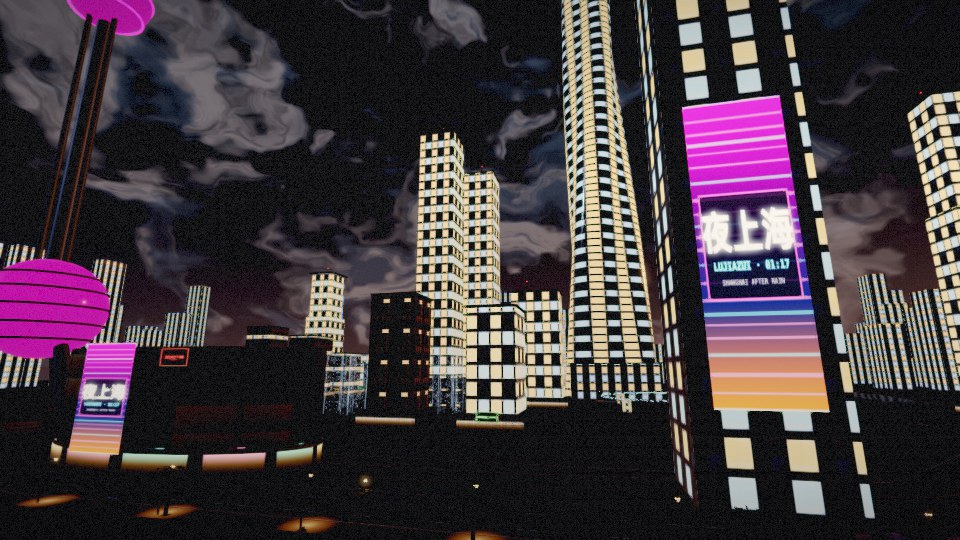
同一座城市被造了两次。第一次,一个模型对着空目录,从「做一个类似 GTA 的 3D 城市游戏」开始,一段一段把细节磨出来,磨到能走、能开车、能坐船、能飞无人机、能进七间店、能上塔顶、能赶末班渡轮。第二次,另一个模型把同一份代码接过去,重写成另一套东西。
两次都留下了记录。这篇文章只问一个问题:这段差距,到底发生在哪里。
两段会话
第一段用两天多、44 轮细节迭代做完,最后被一句「打开以后动不了」叫停。
第二段换了一位执笔者:起笔是 Fable 5.2,收尾是 Opus 5.5。它没有从零开始——第一句话是「复制一份,然后还是优化,特别是建模质量,很多逻辑 bug,游戏复杂度」。
所以这不是两个模型各做一遍,而是一个接力:第二段拿到的是第一段的完整产物。这反而让对比更公平:同样的题目、同样的起点、同一套验收,只换了执笔的人。
数字对照
先看能数的部分,因为下面的判断都要靠它:
| 第一段 · DeepSeek | 第二段 · Fable 5.2 / Opus 5.5 | |
|---|---|---|
| 人工指令 | 25 | 24 |
| 会话跨度 | 51.5 小时 | 约 29 小时 |
| 产出代码 | 13 个文件 · 9,272 行 | 27 个文件 · 14,934 行 |
| 游戏层 | 单闭包 2,762 行 | 拆成 5 个文件,共 4,495 行 |
| 单文件体积 | 2.03 MB | 2.55 MB |
最扎眼的是第一行和最后一行同时成立:人说的话一样多,产出多了一半,结构翻了一倍,而花掉的时间还少一些。如果差距在提示词,这条不该出现——两段的提示几乎同源,甚至第二段的开场更短,只是「复制一份,然后优化」。
第一段:六个阶段
把第一段的 25 条指令按顺序排开,会看到很清楚的阶段。下面每一条都是用户原话,只隐去了具体时刻。
| 阶段 | 人对它说的话 | 这一阶段做了什么 |
|---|---|---|
| 开场 | 「做一个类似 GTA 的 3D 城市游戏……先满足精细要求再广度」 | 立骨架:单文件、three.js、城市、车、行人、明信片 |
| 开场几分钟后 | 「不要学 GTA 那种做犯罪的事情……可以开车,搭车,走路,还有游客任务」 | 把犯罪循环换成游客循环 |
| 同一时段 | 「能不能通过开源数据地图,真实放置建筑」 | 接 Overpass,按 OSM 真实坐标重建路网、建筑、岸线 |
| 当天下午 | 「建筑还是很粗糙……车的加速转向不尽人意」 | 重做车(温室、轮拱、轮圈、缝隙)、人物、塔楼退台 |
| 当天傍晚 | 「路况还是不够精细」「路面的镜面反射好假」 | 路缘石、车道线、斑马线、井盖、盲道、信号灯;湿路面改粗糙反射 |
| 当天夜里 | 「从正大广场出来就有个亲水平台……和你呈现的一样么?差在哪?」 | 外滩 52 栋石构建筑带、底层橱窗、入口雨棚、对岸城区 |
| 同一晚更晚 | 「穿模了……渡口有楼挡住了……江面也没有东西」 | 修穿模、清渡口走廊、行人 48 → 110、江面 6 艘船、无人机停机坪 |
| 第二天 | 「很多物体都还是很粗糙的长方体,一点也不写实」 | 圆角车身、胶囊人物、成簇树、入口门洞与雨棚 |
| 第二天傍晚 | 「这个桥一点不符合实际,请你仔细查查」 | 375 步重做南浦/杨浦/卢浦三桥,加出租车沿途报站 |
| 第三天上午 | 「我在想是不是不要倒计时,这样更自由」 | 去倒计时,改自由漫步,HUD 改成 ∞ |
| 收工前 | 「我刚刚发现,打开以后,都动不了目前」 | 一个变量名拼错,整帧抛异常;修好后 8/8 |
注意这些句子的形状:没有一条是「请把它做得更高级」,全部是「这里不对」。模型每一轮都能把被指出的那一个点修好;但它不会自己指出下一个点。
每一轮在改什么
挑几轮说细一点,因为「粗糙」和「精细」之间的差别,正是这 44 轮的内容。
接上 OSM 的那一轮。模型先用 Overpass 拉数据,失败,换镜像,再拉;然后把建筑轮廓、路网、岸线按真实坐标重投影,地标从手摆的位置挪到 OSM 的实际位置。这一轮的产出不是更好看的画面,而是整个项目换了一套坐标系:之后所有的车、行人、出租车的寻路、小地图,全部改挂到真实路网上。
「镜面太假」的那一轮。它没有把反射调暗就结束,而是把路面从镜面改成湿沥青:Fresnel 边缘、模糊、竖向拉丝、涟漪、湿斑遮罩。这类改动在截图里不显眼,但它决定了雨夜是不是像雨夜。
外滩那几轮。用户拿真实动线做对照——从环形天桥出来,沿滨江大道走到亲水平台,正面应该是一片石构建筑带。模型先只做了一排,用户指出「对面一片都是建筑,你也得实现吧」;于是补出整个对岸街区、边界处的实体标识与警戒线。
街道密度那几轮。「路上东西也不够多」这一句,模型一口气跑了 277 步:路边停车、共享单车、行人背包、面包车、餐车、街道家具,一轮接一轮地加,每加一次跑一遍验收,再贴一张图。
桥那一轮。第一版的三座桥被判定「一点不符合实际」,接下来那一次是 375 步:查南浦、杨浦、卢浦的实际结构,重做 H 形桥塔、双索面拉索、拱肋,顺手加了出租车沿途报站。
八道门一直绿着
这个项目挂着一套六加二道验收:shader、对象普查、碰撞、灯光、回路、观感,加产品与移动端。整套流程在会话里几乎每次收尾都是 8/8 PASS。
但用户在同一个时间段里说的是「粗糙」「好假」「不符合实际」。这不是自相矛盾,这是两种尺子:门测的是阈值,人测的是像不像。八道门能回答「有没有 shader 错误、碰撞是否一致、draw call 是否超标」,回答不了「这栋楼像不像上海」。
更值得注意的是模型面对预算时做了什么。场景一复杂,draw call 就超:
| 节点 | 实际 calls | 处理 |
|---|---|---|
| 外滩一排 + 浦西街区 + 亲水平台 + 无人机 | 1,236 | 把声明预算从 1,000 提到 1,300 |
| 外滩 52 栋加底层橱窗与雨棚 | 1,780 | 把预算从 1,600 提到 1,900 |
它自己在回复里写明了这件事,原话是:「这是提高预算,不是优化。」这句话比任何 8/8 都更有信息量——模型知道自己在做什么,它只是选了更容易的那条路。
卡死的那一行
第一段收尾时,用户打开页面,发现画面在、但人物和车完全不动。原因是一行:
if (S.mode === 'foot' && C.cafeSeat.active)——C.cafeSeat不存在,应该是S.cafeSeat。
这一行每一帧都抛 TypeError,整个游戏循环直接中断。它和审美无关,和架构无关,就是少敲了一个字母。修完之后,页面错误从每帧一条回到 0 条,验收又回到 8/8。
这件事值得写进来,因为它标出了这套流程的真实边界:293 张截图、44 轮自检、8 道门,都没能替代人打开页面走两步。
第二段:换模型之后
第二段开场,它先把整个项目复制了一份,然后做了一件第一段没做过的事:它试着把建模拆成四条线并行推进——车与人、城市与道路、地标与桥、滨江与室内。四条线一条都没跑完,只留下彼此不咬合的半成品。
接下来的反应是这个对比里最有意思的一处:它没有硬着头皮继续并行,也没有把半成品当成完成,而是先承认「这四个任务都中断了……现在不能说它没有 bug」,再自己改计划:不再分包,串行做,每个阶段过验收才进下一个阶段。
然后它做了三件事。
一,先动结构。第一段的 30-game.js 是一个 2,762 行的闭包,状态、时钟、移动、驾驶、室内、相机、地图、手册全在里面。第二段开工不久就把它拆成五个文件:核心、运动、室内、相机与 HUD、主循环。这一步不产生任何新画面,但没有它,后面的系统塞不进去。
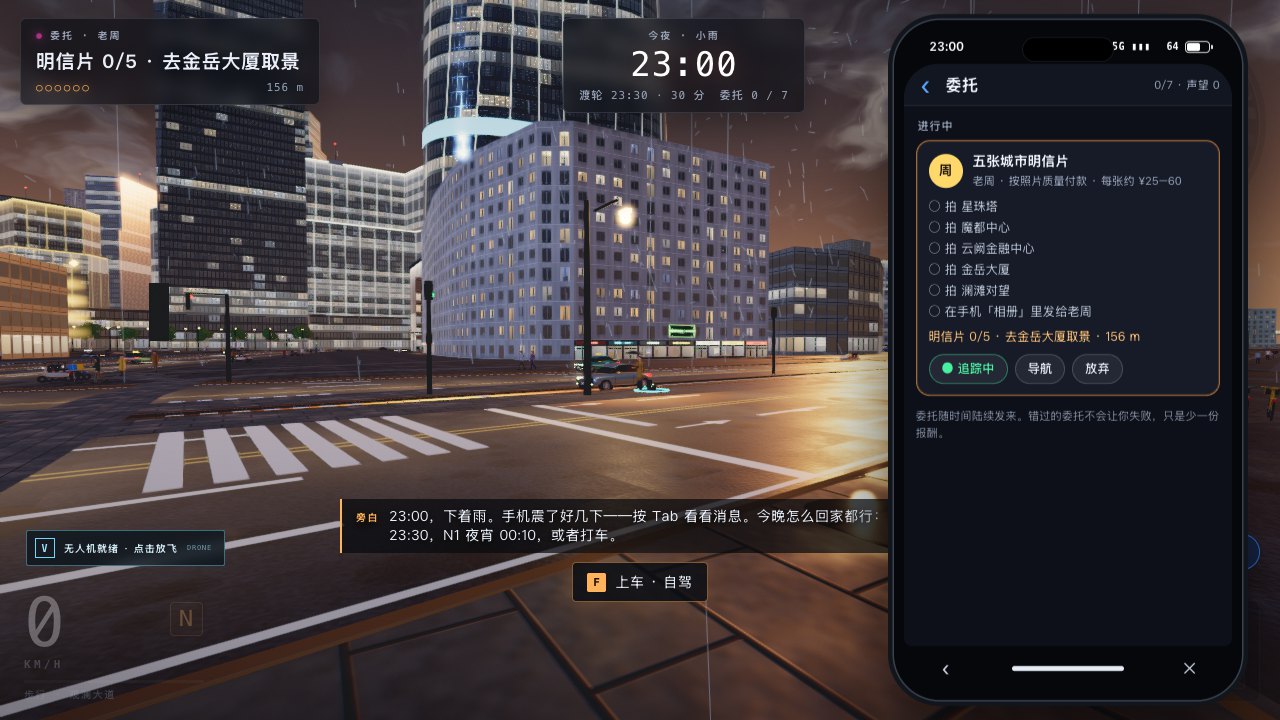
二,把「一句话」变成一层系统。用户说的是:「我在想是不是可以有个模拟手机,这样地图啊,导航啊都可以放进去,包括任务。请你重新审视现在的游戏状态,更正游戏的策略,首屏,以及名字。」这句话没有任何规格。模型交回来的是:手机八个 App(消息、委托、地图、打车、相册、钱包、手账、时刻)、手机电量与借线充电、七条随时间推送的委托、四种回家结局与 S/A/B/C 评级、新的首屏、新的名字、跟着改写的 README 与手册。
三,自己收尾。它会主动划出验收边界:哪些路径真的跑过,哪些只验证到一半(真实浏览器里的鼠标锁定、真机上的手机版),而不是把「脚本跑通了」当成「验过了」。这不是自我表扬式的总结,是把边界写在交付里。
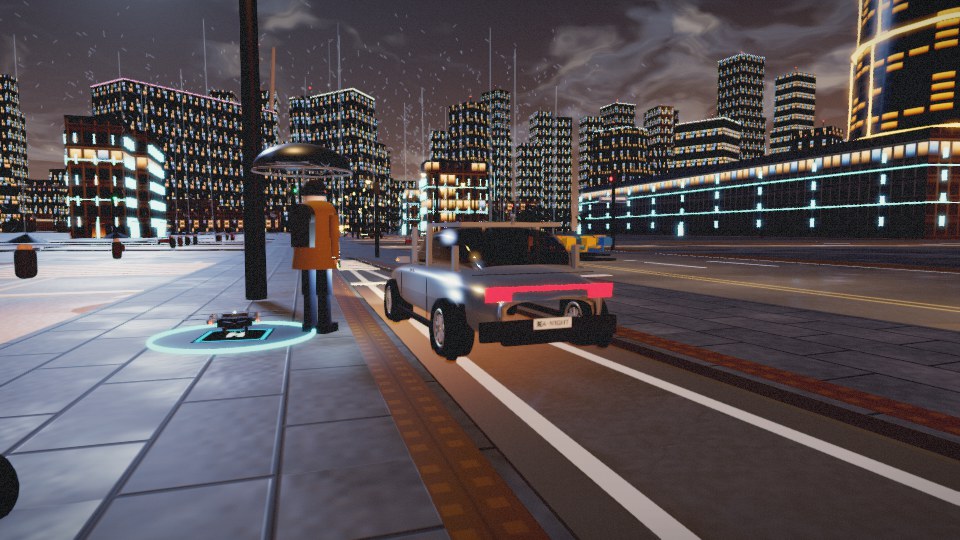
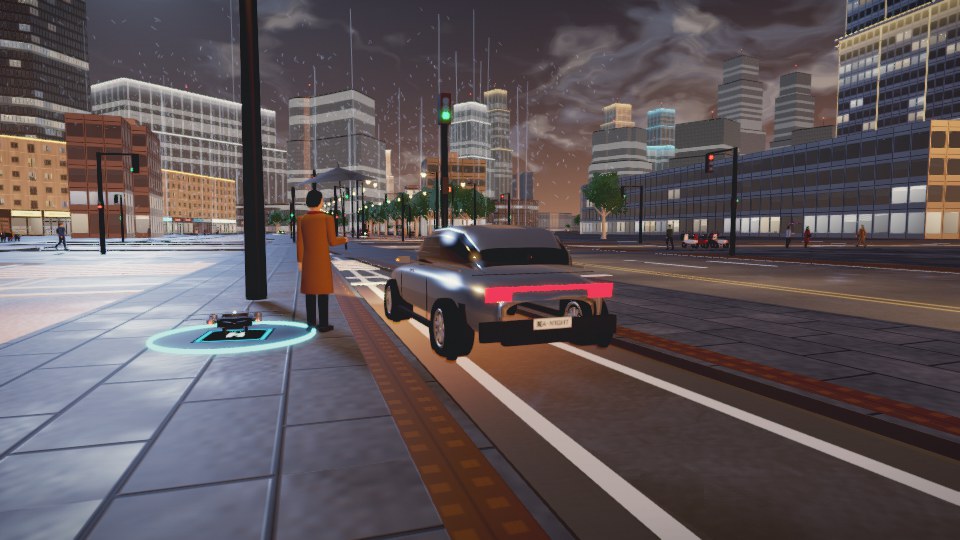
两张图是同一个相机预设、同一个城市、同一条街。差别不在某一件模型,而在这几件事同时发生:立面有了分层与退台,窗格不再是均匀点阵;车从硬边方块变成有轮拱和曲面的形体;阴影和雾把远景推远了;路面从「亮片」变成有粗糙度的湿沥青。
提示在哪?
「后来那次为什么好那么多」这个问题,很容易被回答成「提示写得更好」。两份记录放在一起,这个答案站不住。
第二段的人工指令是 24 条,和第一段的 25 条几乎一样多。而且形态也一样,全是短句和抱怨:「现在这个玩法太单一了」、「桥能否放在他该在的地方」、「怎么河中心还是建筑啊」、「叫车时间太长,一直没来」、「很多行人穿墙」。整段会话里最长的一条,就是那句要手机的话——也不是规格,是一个想法。
所以变的是「一句指令能推动多少东西」,不是「指令写得多好」。同样一句「加个模拟手机」,第一段大概率会交回一个能开合的界面;第二段交回的是一层把地图、导航、委托、相册、钱包、电量、结局全部重新咬合的状态机。
差在四处能力:
- 自己找问题的能力。第一段的每一轮都建立在「人先指出哪里丑」之上;第二段仍然靠人开口,但它会先自己审一遍现状,把「玩法策略还是最早的限时冲刺」「首屏有错误」「HUD 需要记 11 个按键」列成清单再动手。
- 同时握住整个系统的能力。那句手机需求牵动规则、首屏、命名、手册与 README;能一次改到自洽,靠的是把整个项目放在同一张图上。
- 结构感。拆成五个文件不产生新画面,但它决定了第八个系统能不能塞进去。
- 对「像不像」的判断。这是最难的一条。第一段能通过 8 道门,但过不了人眼;第二段在同一条街上做到了更像。
但也不能把第二段说成「一次就成」。它试过并行分包、失败了、自己重排计划;它交回来的东西仍然带着「没测到」的清单;最后真正发现问题的,还是人打开页面走两步。换模型降低的是「把系统做对」的成本,没有消除「判断什么该做」的成本。
结论
这次实验量到的,不是「哪个模型会写代码」。两个都会。量到的是反馈带宽:一句话能换来多少自洽的改动。
第一段用 25 条指令、44 轮自检、293 张截图、两天多的时间,换来一座能玩、但每一处细节都要人指认的城市。第二段用 24 条指令、十分之一的实际工时,换来同一座城市,加上一套自己的日程、委托、结局与手机。
而那 8 道门在两段里都是绿的。它们证明了很多事——shader 没坏、碰撞一致、灯都有锚点——唯独没有证明「好看」。所以最后能拿走的结论很朴素:
门可以判断「有没有」,人才能判断「像不像」。模型不觉得丑,人觉得。
这句话对两段都成立。区别只是:第一段需要人说 25 次,第二段需要人说的次数没少,但每一次都多推动了一大块。
参考 / 魔都夜行在线版 · 源码 · Work 里的案例 · photoreal-game skill。数字来自两次执笔的完整记录与两个版本的源码。这是一次工程复盘,不是产品评测。