RoomTessera 的第一句话很简单:导入一张户型图,自动生成 3D 视图,然后自由摆放家具。它听起来像一个识别问题。做完才发现,识别只是入口,真正的工作量在“识别错了以后怎么办”。
这个项目经历了 16 轮明确反馈。前几轮在加功能:房间、家具、材质、灯光、保存。后面几乎都在处理同一件事——墙。加粗的承重墙被识别宽了,墙体接头突出,某些墙角变成斜线。每一轮都说“识别还是有问题”,每一轮修完,下一个户型又冒出来。
自动识别的承诺
自动识别能做的事很具体:估算户型范围,找到地面轮廓,切分房间,算出面积。对一张干净的平面图,这些结果已经足够开始布置。用户不需要先画一个空盒子,家具也有了可放置的边界。
问题在于,户型图不是为算法画的。它有线宽、有标注、有家具遮挡、有阴影,甚至有透视。墙的“中心线”和“可见边”不是同一条线。加粗的承重墙在图上看起来更宽,算法很容易把整段厚度当成墙体,生成一个胖了一圈的房间。
墙体为什么歪
最典型的失败是三类:
- 加粗墙变宽。 图上的墙有厚度,识别把外沿当成中心线,房间被吃掉一块。
- 接头突出。 两段墙相交时,线段端点没有正确合并,3D 里就多出一个小方块。
- 墙角变斜。 图上有轻微透视或扫描倾斜,算法把一条本应水平的线拟合成斜线,房间随之歪掉。
这些不是“模型再大一点”就能全解决的问题。输入本身缺少深度信息,墙的语义也没有唯一答案。一个更诚实的定位是:自动识别给出可编辑的草稿,而不是最终户型。
把自动降级为草稿
产品上的转折点,是把“识别结果”从结果改成草稿。界面不再假装它一定对,而是允许人直接改:水平/垂直墙线、点击或拖动擦除、清空全部自动墙、10cm 网格吸附、20 步撤销。
这个改变看起来不酷,但它让工具从“演示”变成了“能用”。用户不需要和算法争论,只需要把错的那一段拉直。自动识别负责把 80% 的空间关系摆出来,手动墙线负责最后 20% 的精度。
自动识别的价值不是替人做完,而是让人少做一点。
同时保留原始户型底图叠加,也很重要。人需要对照原图判断墙在哪里,而不是在 3D 里凭记忆修。底图、网格、墙线和房间标签在同一个平面视图里,修正才是一个可理解的动作。
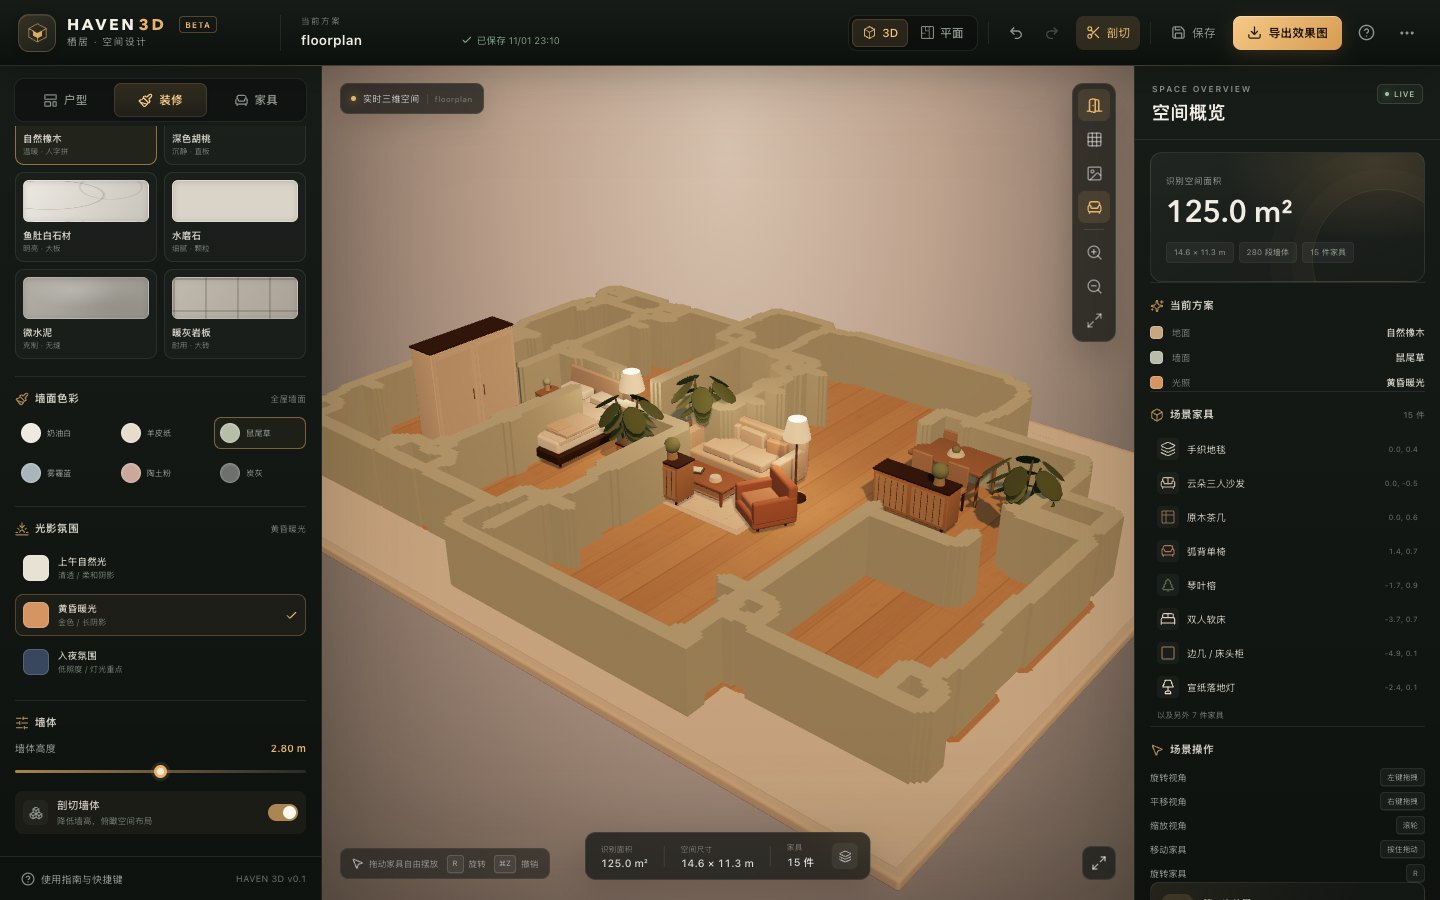
修正界面才是产品
除了墙线,项目还做了几件让“草稿”变得可用的东西:
- 平面 / 3D 双视图。 在平面上修结构,在 3D 里看空间,两个视图共享同一份数据。
- 碰撞提示。 拖动家具时实时检测墙体、其他家具和空间边界,重叠变红。
- 智能落位。 新家具先找一个能放的位置,用户再微调,而不是从原点拖进来。
- 本地保存与导出。 方案存在浏览器里,可导入导出 JSON,也可导出当前视角 PNG。
- 材质与灯光。 6 种地面、6 种墙色、3 种光照氛围、4 套全屋风格,让草稿能快速变成一个可看的方案。
这些功能没有一个是“识别更准”。它们都在回答同一个问题:识别错了以后,用户能不能在不离开页面的情况下继续工作。
本地优先
RoomTessera 是纯前端的:识别、渲染、存储都在浏览器完成,没有后端,也没有账号。户型图和方案不上传服务器。这不是一个技术炫耀,而是这类工具的最低信任条件——家装平面图是私人的,用户不应该为了试一下就要先注册。
本地优先也带来约束:没有服务端的大模型,识别只能是启发式;没有云端同步,方案要能导出;没有后台任务,所有计算都要在前端可接受的时间里完成。这些约束反而让产品更清楚:它是一个本地工作台,不是一个“AI 设计平台”。
该测什么
如果只用“墙体像素准确率”评估,这个项目会显得很失败。更有用的指标是:
- 修正时间。 从导入到得到可用户型,需要手动改几段墙、几分钟?
- 失败可恢复性。 墙歪了以后,用户能不能在一两步内拉直,而不是重来?
- 首次可用率。 不改任何东西,生成的 3D 能不能直接开始摆家具?
- 空间可读性。 8 个房间、15 类家具之后,画面是否还看得懂?
这些指标更像产品指标,而不是模型指标。它们也解释了为什么“再训练一个更强的识别模型”不是唯一答案:用户真正需要的是控制感。
结论
图像转 3D 的难点不是把图变成几何,而是把几何变成可编辑、可修正、可保存的东西。自动识别可以让你少画几笔,但不能替你做决定。一个没有修正界面的“AI 生成 3D”,在真实户型上很快会变成死胡同。
RoomTessera 现在还是一个 v0.1:墙体识别是启发式,复杂户型会失败,手动工具也还需要打磨。但它至少承认了这件事,并把修正放进了产品,而不是藏在“识别准确率”后面。
参考 / 在线 Demo:roomtessera-3d;源码:NorwinYu/roomtessera-3d。项目页:RoomTessera 3D。这是开发复盘,不是对识别精度的评测。