十一月六日晚上,我在本地让 agent 用一句中文 prompt 生成了一个明朝宫殿:单文件、原生 WebGL2、鼠标能拖着换角度。跑的是 DeepSeek-V4.1-Flash-1017 的 Maya-XS 量化包——每专家约 1.6 bit、93 GB,两张 22GB 的卡加 94 GB 内存做 TP=2,131K 上下文。一周后的十一月十三日,同一个题目的原版做了另一版,现在挂在线上。
所以这不是「两个模型」的对比,是同一个 checkpoint 的两种权重:一边激进量化,一边原版。两版都能用,都只有几十 KB,都不依赖任何外部文件;但并排看,能看出预算花在了完全不同的地方——一版买氛围,一版买结构。
两次运行
| 项 | 本地那版(量化) | 线上那版(原版) |
|---|---|---|
| 权重 | Maya-XS · 每专家约 1.6 bit · 93 GB | 原版 |
| 硬件 | 2 × RTX 2080 Ti 22GB + 94 GB 内存 · TP=2 | 未记录 |
| 上下文 | 131,072 | 未记录 |
| 采样 | temp 1.0 · top_p 1.0 · reasoning high | 未记录 |
| 日期 | 2026-11-06 | 2026-11-13 |
| 产物 | 单文件 HTML · 91,195 B | 单文件 HTML · 85,402 B |
| 行数 / 函数 | 2,333 行 · 41 个函数 | 2,317 行 · 53 个函数 |
| 绘制调用 | 3 次 | 5 次 |
| 离屏渲染 | 无 | 1 个 framebuffer |
本地那版
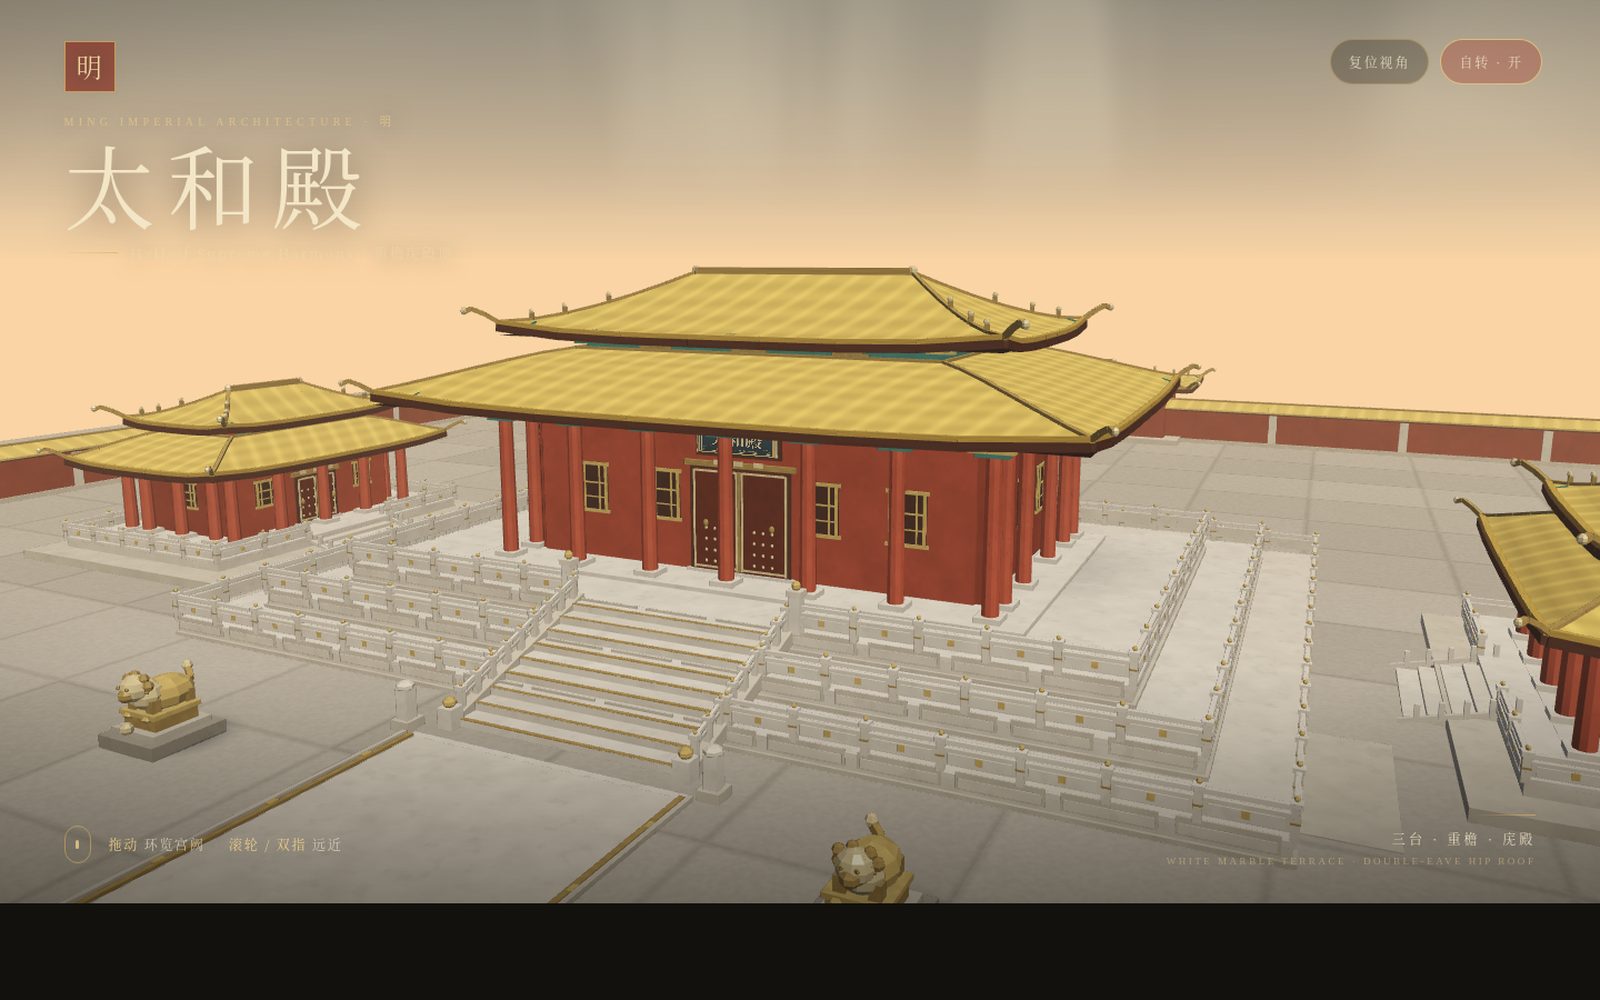
它选了黄昏到清晨之间的那种光:橙色天幕、暖金屋顶、白石台基带一点点暖反,整体压暗,四角有暗角。构图不是正立面,而是带透视的斜角,左右各留了一座配殿,前景蹲着铜狮,院子铺满方砖。
界面只有两个按钮(复位视角、自转)和一行操作提示。它没有给你视角预设——它更像在做一个场景,让你自己转着看。
从会话记录看,这次生成用了 129 个步骤、15 次写入或编辑同一个文件。prompt 的原文就是一句话,还额外要求「独立完成,不参考其他文件和网络资料」。
值得记住的是权重有多小:Maya-XS 把每个专家压到约 1.6 bit,整个包 93 GB,靠两张 22GB 的卡加 94 GB 内存才装下;解码速度大约 25 tok/s。这不是一个「能跑就行」的演示规模,而是这套配置上能跑的最大模型之一。
这一版现在也在线,文件未做任何改动:本地版。可以和新版并排拖着看。
线上那版
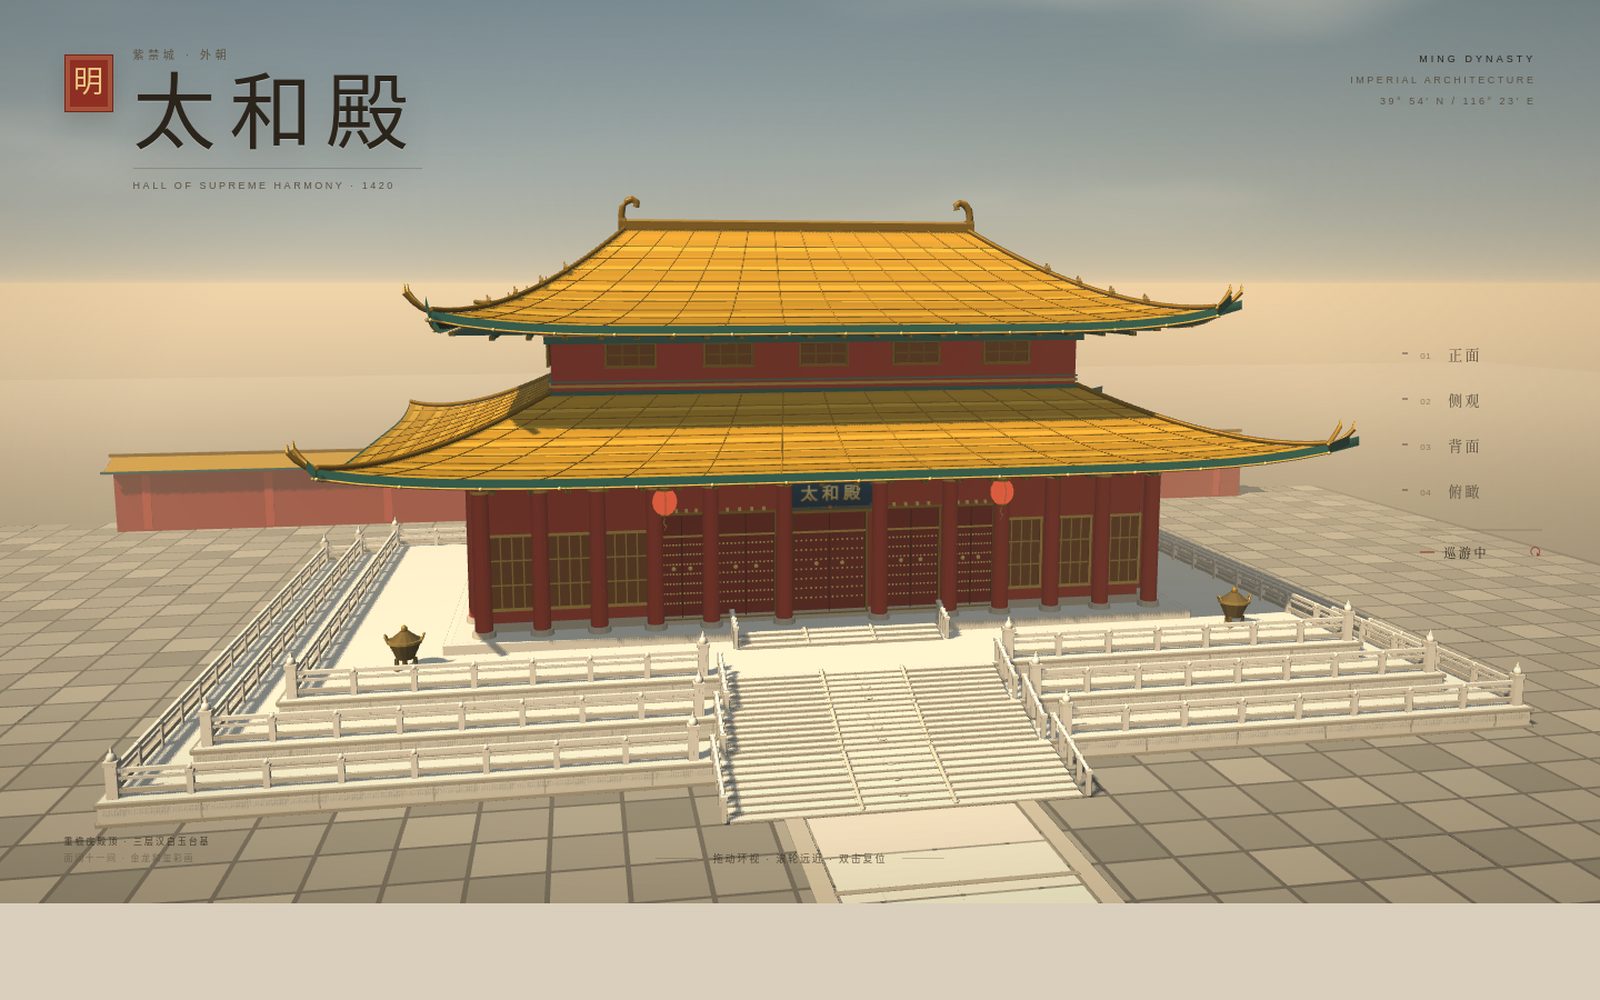
这一版反过来:明亮的薄雾天空、居中的正立面、重檐庑殿顶的层次被强调,屋脊上的走兽、檐下的斗拱排布、匾额的位置都比本地那版更讲究。配殿被收掉,前景换成两只铜鼎,白石栏杆一段一段对齐。
界面也换了思路:右侧四个视角预设(正面、侧面、背面、俯瞰),左上角标了经纬度,底部一行「拖动环视 · 滚轮缩放 · 双击复位」。它更像一张可以转的建筑图纸,而不是一个黄昏的院子。
能数的部分
两版都是手写 WebGL2,没有 three.js 之类的库。可以直接数的差别只有这些:
- 本地那版 41 个函数、3 次绘制调用、1 张纹理、0 个离屏缓冲;
- 线上那版 53 个函数、5 次绘制调用、2 张纹理、1 个 framebuffer;
- 本地 91,195 字节,线上 85,402 字节,行数几乎一样(2,333 / 2,317)。
framebuffer 那一项值得单独说:有离屏渲染,才谈得上后处理——雾、色调映射、或者把场景先画到一张贴图上再合成。线上那版的天光和空气感很可能就来自这里;本地那版把预算花在了更多几何体上(配殿、狮子、院落),只用 3 次绘制调用画完。
同等的代码量,一个买了更多模型,一个买了更好的合成。
这不是受控对比
必须说清楚:这不是 A/B 测试。
- 权重不同(量化 vs 原版)正是要观察的变量,但两边的采样参数没有对齐;
- prompt 只确认了本地那次的原文,线上那版在站点里只记为「一句中文 prompt」;
- 两次相隔一周,期间工具链、脚手架和 agent 预设都可能变过;
- 没有共同评分标准,好看与否取决于你想要哪一种。
所以能说的只有一件事:压到每专家 1.6 bit 之后,这个任务没有崩——它仍然从一句话走到了可交互的单文件场景,只是把钱花在了不同的地方。
留下的判断
如果目标是「一张能当封面图的截图」,量化版的暖光仍然成立;如果目标是「一个能讲清楚的建筑」,原版的视角预设和重檐细节更有用。但这份差别不能单独归因给量化——采样和 prompt 也没对齐。
真正让我意外的不是质量,而是体积:两版都在 90 KB 上下,都是零素材、零依赖。模型没有把宫殿存成模型文件,它是把宫殿写成了一段程序;而写出这段程序的那一边,权重只剩 1.6 bit。
方法 / 本地版来自 2026-11-06 的归档会话(provider maya,model deepseek-v4.1-flash,量化包 DeepSeek-V4.1-Flash-1017-GGUF/Maya-XS,131,072 上下文,TP=2),产物为单文件 HTML;线上版为 deepseek-flash-1017-ming-palace(仓库 2026-11-13 创建)。函数数、绘制调用、纹理与 framebuffer 数量由对两份 HTML 的静态检索得出,不是运行时 profile;截图分别是两版在 1440×900 下的首屏。